CoreWeave i Nebius: mniej konfiguracji, więcej pracy nad robotem
W robotyce coraz więcej czasu kosztuje nie sam model AI, lecz uruchomienie całego eksperymentu. CoreWeave i Nebius opisały 21 października 2026 narzędzia, które mają ograniczyć pracę przy łączeniu symulacji, danych, obliczeń i oceny wyników. CoreWeave stawia na gotowe konfiguracje zadań Physical AI Launchables, a Nebius na otwarty Physical AI Workbench. To infrastruktura rozwoju robotów, nie nowe roboty do kupienia.
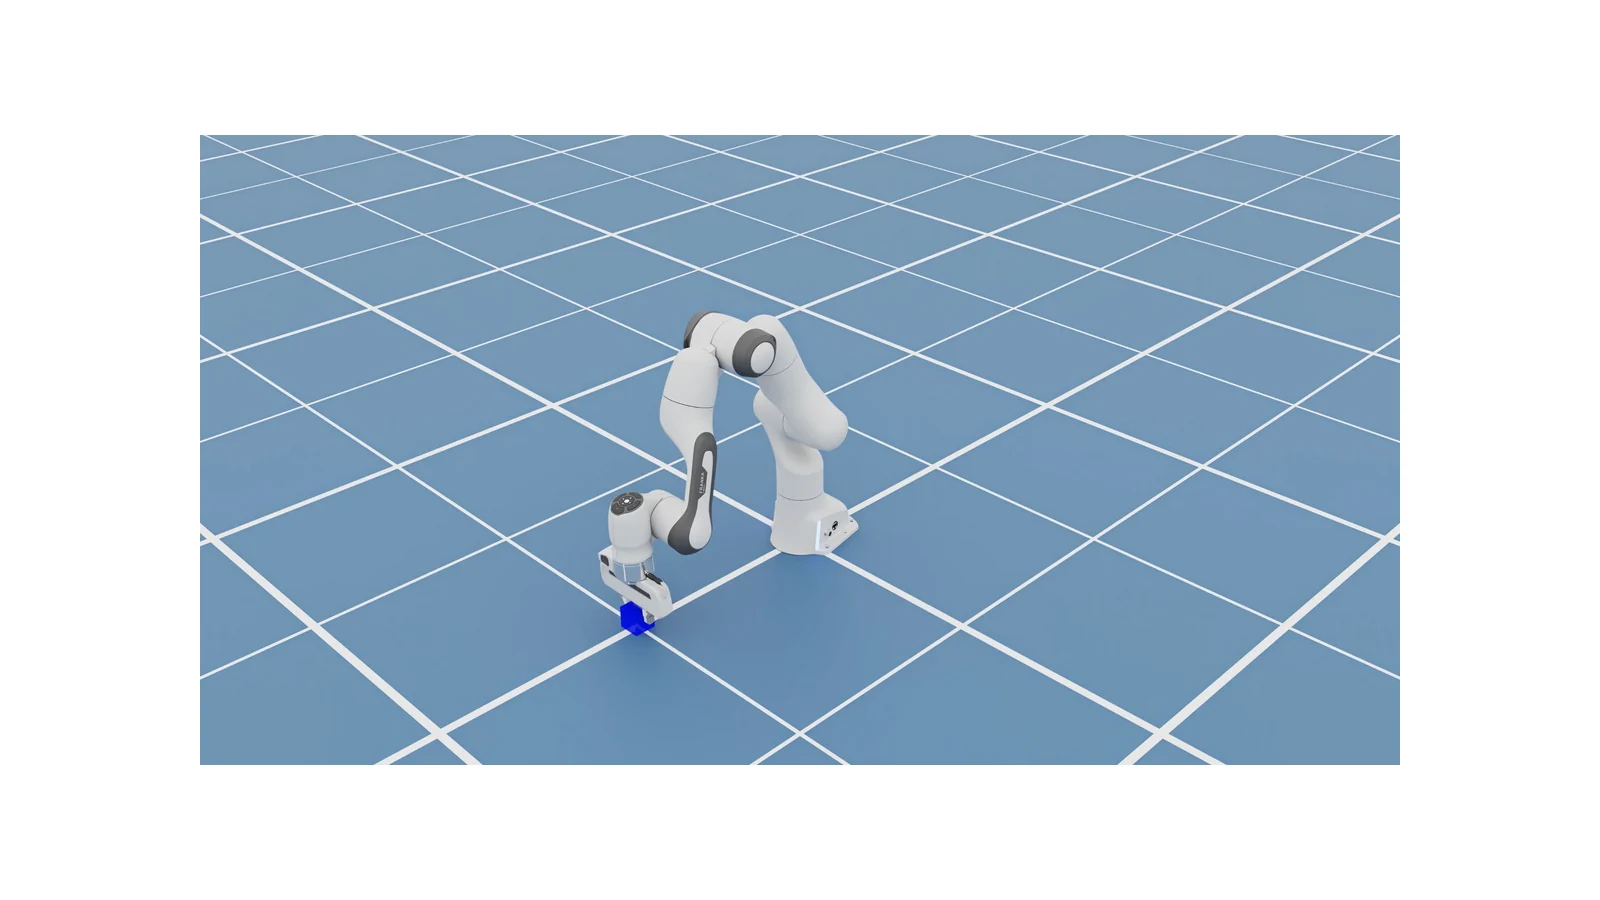
Oficjalny obraz CoreWeave: Franka w Isaac Sim. Obraz przedstawia symulację, nie fizyczne wdrożenie ani test RoboMorrow.
Dwie propozycje, wspólny problem
Zanim zespół porówna dwa sposoby chwytania przedmiotu, musi przygotować środowisko, dane, zasoby i zapis wyników. Jeśli każdy eksperyment zaczyna ten proces od nowa, trudno ustalić, czy poprawił się model, czy zmieniła konfiguracja. Nasz wniosek: wartość takich narzędzi należy oceniać przez powtarzalność i czas pracy zespołu, a nie samą liczbę obsługiwanych nazw oprogramowania.
| Pytanie | CoreWeave Physical AI Launchables | Nebius Physical AI Workbench |
|---|---|---|
| Punkt startowy | Przetestowane przez dostawcę szablony zadań i środowisk | Otwarta warstwa organizująca przepływy pracy i działania agentów |
| Zakres opisany 21.10 | Isaac Sim, CARLA, MuJoCo, AlpaSim, Cosmos 3 | Generowanie danych, symulacja, trening i ewaluacja; narzędzia NVIDIA i partnerów |
| Co pozostaje zadaniem zespołu | Własne sceny, dane, parametry i interpretacja wyniku | Definicja zadania, dane, konfiguracja i potwierdzenie efektu na robocie |
| Najważniejszy test | Czy ten sam eksperyment można odtworzyć wraz z artefaktami? | Czy przepływ jest czytelny, kontrolowalny i odtwarzalny? |
CoreWeave: zacząć od działającego środowiska
Według CoreWeave Launchables zawiera szablony uruchamiane jednym poleceniem. Można zmieniać parametry lub kod zadania, korzystając z przygotowanego środowiska. Firma opisuje m.in. symulację manipulacji ramieniem Franka, generowanie scen magazynowych i ocenę scenariuszy jazdy. Pakiet obejmuje także umiejętności dla agentów programujących. To opis oferty dostawcy, nie nasz benchmark szybkości.
Jedno polecenie upraszcza uruchomienie, ale nie definiuje jakości eksperymentu. Przy demonstracji poproś o zmianę pojedynczego parametru, zapis wersji danych oraz ponowne odtworzenie poprzedniego przebiegu. Obejrzyj również nieudany run: czy raport pokazuje błąd merytoryczny, brak zasobu i zakończenie procesu jako różne sytuacje? Zakończone obliczenie nie oznacza udanego zadania robota.
Nebius: otwarty przepływ pracy i konkretny europejski kontekst
Nebius opisuje Workbench jako otwarty framework do pełnego cyklu Physical AI. W komunikacie łączy narzędzia NVIDIA z rozwiązaniami partnerów, a wśród przykładów wymienia współpracę z Sereact nad przepływem sim-to-real dla obsługi zwrotów Zalando. Firma przywołuje deklaracje klientów o skróceniu czasu inżynierii nawet o 40%. Nie jest to opublikowany wspólny benchmark przeciw Launchables.
Różne zwracane towary, opakowania i etykiety dobrze pokazują problem. Scena treningowa może wyglądać przekonująco, a mimo to nie obejmować odkształconego pudełka albo chwytu z zasłoniętą etykietą. Dlatego sukces infrastruktury powinien być połączony z testem nowej polityki na reprezentatywnym zbiorze przypadków. Sam eksport modelu nie zamyka drogi z symulacji do magazynu.
RoboMorrow opisywało już roboty obsługujące zwroty Zalando w Świebodzinie. Nowy komunikat dotyczy narzędzi rozwoju i współpracy, a nie potwierdzenia, że cała opisana infrastruktura działa już w tym konkretnym polskim obiekcie. Nie utożsamiamy nazwy wspólnego klienta z tożsamością wdrożenia.
Co powinien sprawdzić zespół przed wyborem chmury
Zacznij od kompletnego kosztu jednej użytecznej iteracji. Obejmuje on przygotowanie danych, oczekiwanie na zasoby, obliczenia, przechowywanie, pobranie wyników i czas inżyniera. Tańsza godzina GPU może dawać droższy eksperyment, jeśli zespół długo odtwarza błędy. Nie podajemy stawek ani rankingu kosztów, bo nie wykonaliśmy porównywalnej wyceny dla tego samego zadania.
Następnie sprawdź przenośność: czy możesz zachować sceny, konfiguracje, dane i wyniki w użytecznej postaci? Otwarty kod warstwy organizującej pracę nie oznacza automatycznie bezpłatnych obliczeń, dostępu do każdego komponentu ani łatwej migracji całego systemu. W umowie i dokumentacji szukaj konkretnej odpowiedzi dla używanych narzędzi.
Trzecia sprawa to kontrola agenta. Zespół powinien widzieć, co agent zmienił, jakie zasoby uruchomił i do których danych miał dostęp. Dobry zapis eksperymentu pozwala odróżnić nowy wynik od przypadkowej zmiany środowiska. Przed zastosowaniem modelu w rzeczywistym robocie nadal potrzebna jest kontrola odpowiednia do zadania i otoczenia.
Nasz werdykt: porównuj dowody, nie hasło „one command”
Launchables i Workbench zasługują na uwagę, bo adresują mniej widowiskowy problem robotyki: czas pomiędzy pomysłem a wiarygodnym wynikiem. Nie wskazujemy zwycięzcy bez uruchomienia tej samej pracy na obu platformach. Na demonstrację przygotuj mały, własny zestaw scen, wymagany format wyników i przykład błędu, który system musi poprawnie zgłosić.
Wcześniejszy materiał o CoreWeave Physical AI Field Engineering dotyczy usług i wsparcia. Nowe szablony są odrębnym elementem oferty. O tym, dlaczego sam robot nie wystarcza bez danych i zarządzania, piszemy także w analizie warstwy danych i floty.
Źródła i metodologia
Redakcja RoboMorrow. Weryfikacja: 26 października 2026. Analiza dokumentacji i materiałów źródłowych; bez fizycznego testu sprzętu. Deklaracje producentów nie są wynikami niezależnego pomiaru.